
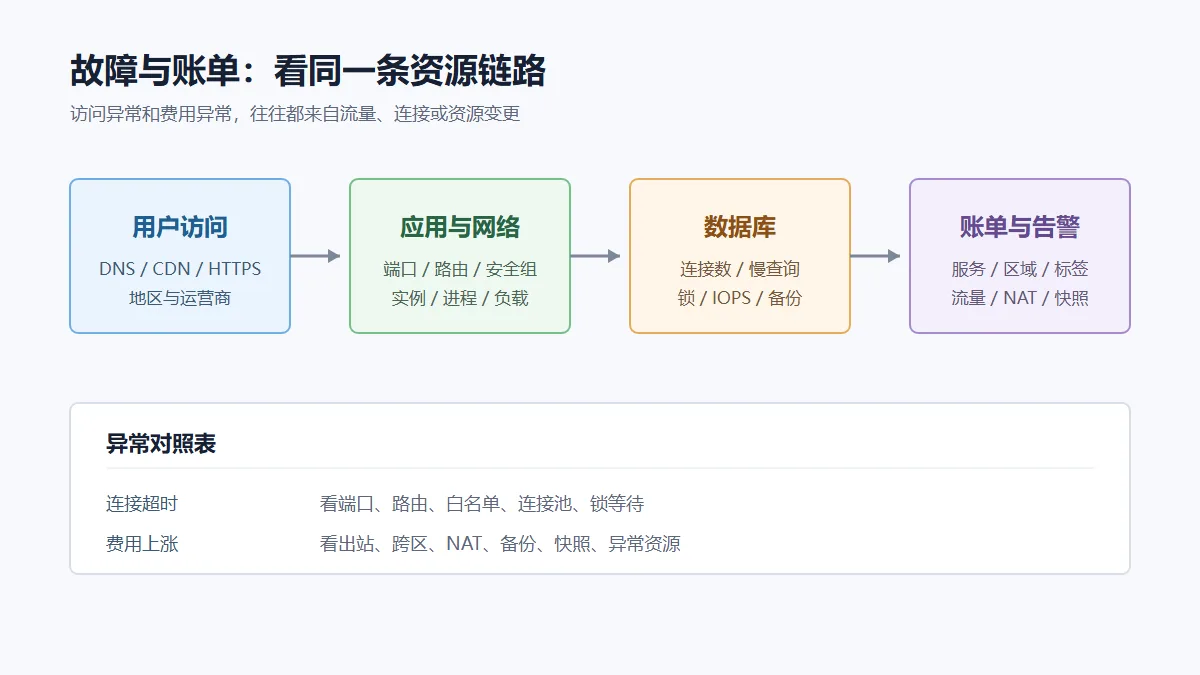
多云架构上线后,最怕故障发生时没人知道问题属于哪朵云。用户说“网站打不开”,可能是 DNS、CDN、负载均衡、安全组、服务器进程,也可能是数据库连接池耗尽。账单突然增加,则可能来自流量暴涨、跨区域复制、NAT Gateway、快照或异常资源。
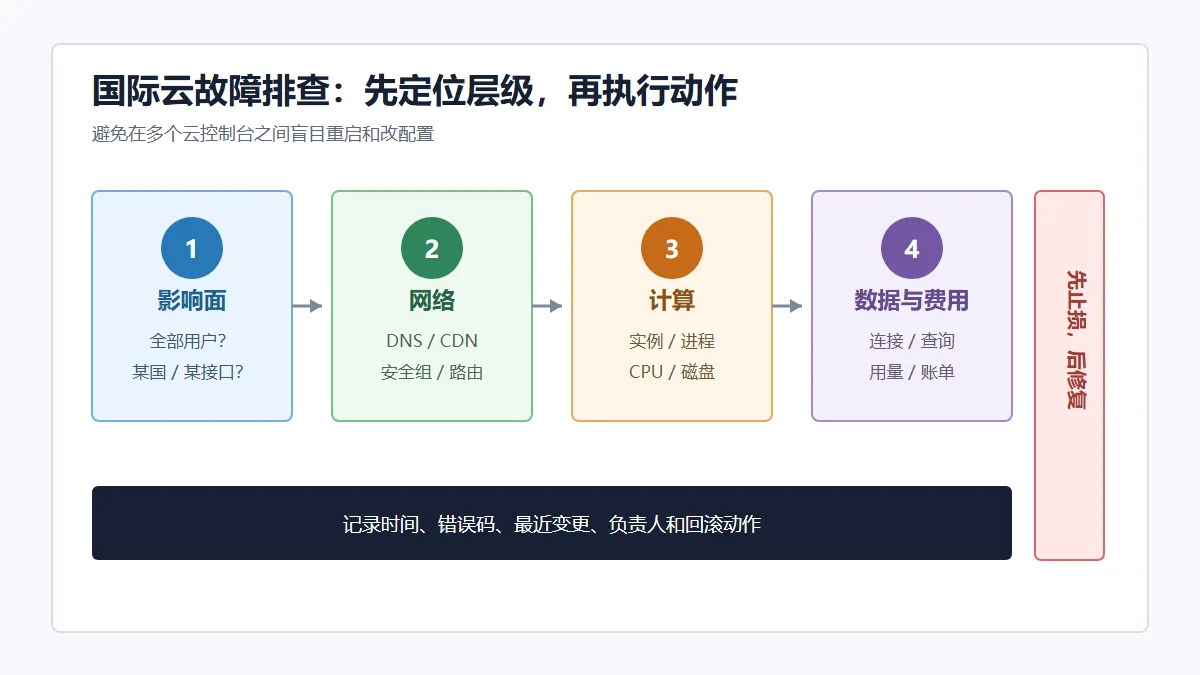
处理国际云故障,重点不是同时打开四个控制台,而是先确认影响范围,再沿着“用户访问—网络—计算—数据库—费用”分层定位。跨境电商、外贸建站和海外 SaaS 应提前记录主云、备用云、区域、账号负责人和恢复联系人。
先做三件事:止损、确认、留证
收到告警后,先确认是全部用户受影响,还是某个国家、区域或接口异常。查看站点探针、CDN 状态、应用日志和云厂商健康面板,记录开始时间、错误码、受影响资源与最近变更。
不要急着重启所有服务器或删除异常资源。批量操作可能清掉现场,也可能让数据库恢复、快照和审计信息变得更难判断。可以先暂停发布、限制异常流量、关闭明显失控的测试任务,保留一条可回滚的变更路径。
如果涉及支付、订单或个人数据,可按预案切换只读页面、排队页或备用区域,并记录时间和负责人。
服务器连不上:从网络层向主机层排查
用户无法访问网站
先测试域名解析、HTTPS 证书、CDN 回源和负载均衡健康检查。若只有某个国家访问失败,重点看 DNS 线路、区域网络、WAF 规则和源站回源路径;若所有地区都失败,再查看负载均衡监听器、目标组和后端实例状态。
SSH 或远程桌面无法连接
确认实例是否运行、所在区域和公网 IP 是否发生变化。检查安全组、网络 ACL、路由表、子网公网网关、防火墙和端口监听。AWS VPC 安全组、Azure NSG、GCP VPC 防火墙、阿里云安全组的规则名称不同,排查逻辑相近:来源地址、目标端口、协议、优先级和返回路径都要匹配。
如果实例状态正常但端口仍不通,可通过云厂商的串行控制台、系统日志或带外管理方式进入主机,查看 CPU、内存、磁盘满载、进程和本机防火墙。不要把“能 Ping”当成服务正常,ICMP 可达不代表 443、22 或数据库端口可用。
数据库超时:区分连接问题和性能问题
数据库超时通常有两类:应用根本连不到数据库,或已经建立连接但查询迟迟没有返回。前一种要检查 DNS、私网路由、安全组、白名单、端口、TLS 和连接凭据;后一种要看连接数、锁等待、慢查询、CPU、内存、存储 IOPS 和磁盘空间。
RDS、Azure Database、Cloud SQL 和阿里云 RDS 都有实例监控、事件或日志入口。不要只把数据库规格调大。先确认是否有突发流量、连接池配置错误、索引失效、批量任务占满资源或跨区域访问。读流量较大时,可评估缓存、只读副本和查询优化;生产数据库需要保留备份与恢复能力。
跨云调用数据库容易出现高延迟和费用叠加。应用在 AWS、数据库在 Azure 或 GCP 时,应测量跨云 RTT、丢包、TLS 握手和连接复用,再判断是否把数据面收回同一区域。临时改 DNS 不能替代架构调整。
账单异常:先找服务和用量,不要只看总金额
发现国际云账单突然变高,可以按服务、区域、账号、标签、用量类型和时间段拆分。重点查看公网出站、跨区域流量、NAT Gateway、负载均衡、对象存储请求、数据库备份、快照、GPU 和临时实例。
AWS Cost Explorer、Azure Cost Management、Google Cloud Billing Reports 和阿里云费用中心都能提供明细。配合 AWS Cost Anomaly Detection、预算告警或各平台的消费提醒,能更早发现异常。账单上涨不一定是故障,也可能是大促流量、日志增长、版本发布或复制策略改变,必须把费用曲线和业务事件对起来。
确认资源异常后,再执行停机、限流、删除快照或调整规则。生产资源的删除动作要先确认负责人、备份状态和恢复需求;跨区域复制、CDN 回源和数据库备份也要检查是否仍在持续产生费用。
四家云出现故障,排查重点有什么不同
AWS 重点看 CloudWatch、CloudTrail、VPC 流日志、RDS Events、健康面板和 Cost Explorer;Azure 可结合 Azure Monitor、Network Watcher、Activity Log 与 Cost Management;GCP 常用 Cloud Monitoring、Cloud Logging、VPC Flow Logs 和 Billing Reports;阿里云国际可检查 CloudMonitor、操作审计、流量监控、安全组和费用中心。工具名称各异,排查顺序仍应围绕影响面、变更记录、网络路径和资源指标展开。
多云团队要维护一张故障联系人表:云账号、主区域、资源负责人、数据库负责人、DNS 管理人和费用负责人分别列出。每家云设置独立预算与异常告警,统一把日志、告警和变更记录送到团队可访问的位置,避免只有某一个管理员能看到关键信息。
中小企业如何降低故障处理成本
业务规模较小时,主云加备用资源通常比四云多活更容易维护。为核心服务建立健康检查、自动备份、镜像、基础设施代码和恢复手册,每季度做一次真实演练。手册要写清服务器连不上看哪里、数据库超时由谁判断、账单异常谁能暂停资源。
如果团队正在处理 AWS、Azure、GCP 或阿里云国际的账号开通、区域选择、充值、预算报价、网络配置或账单异常,可联系 简云AWS 梳理业务影响、资源清单和成本路径,再决定是修复配置、调整架构,还是安排备用云。故障处理的目标不是把所有业务搬来搬去,而是让每一次告警都有负责人和可执行动作。